💻 CSC3150 Week 5 Monitors, Modern Concurrency & Scheduling
Lithos
CSC3150 Lecture8 Monitors
在用 3 个 Semaphore 实现 Buffered Producer-Consumer Lock 中,我们发现仅仅交换两个 P() 就可能造成 Deadlock —— 我们希望有一种更清晰的抽象把 Mutex 和 Scheduling Constraints 分开表达,这就是 Monitor 的设计思想。
Monitors 管程
Monitor 管程抽象 = 一个 Lock + 零个或多个 Condition Variables,用于协调对共享数据的并发访问。
其中锁负责维护 Mutex;条件变量负责维持 Scheduling 限制
Monitor 并不一定是某种独立的硬件结构或特殊对象,它首先是一种并发编程的组织方式 (Programming Paradigm)。Java 等语言原生提供 Monitor 机制;其他语言可以通过 Lock + Condition Variable 实现。
条件变量
Condition Variable 是一个等待队列,用于存放等待某个条件成立的线程 —— queue for threads in critical section to sleep
例如 Condition not_empty; 代表可能存在一些 Consumer 线程正在等待 Buffer 变成非空,它们并非 Busy Waiting,而是 BLOCKED Sleeping,当 Producer 添加数据后,可以通知它们。但是 ⚠️ Condition Variable 本身不存储条件是否成立。
对比 Semaphores:
-
Semaphore 内部有计数值;而 Condition Variable 没有类似的资源。
-
Semaphore 通常不使用普通 Mutex 而利用自身操作 (二进制信号量) 实现;Monitor 通常配合使用 Mutex + 条件变量。
-
Condition Variable 允许线程在临界区内 (持有 Mutex 情况下) 调用
wait(),因为它能在进入等待状态时 ⚠️ 原子性地释放锁,从而避免持锁睡眠造成的 Deadlock,也避免释放锁与进入等待之间发生的 Missed Wakeup。这也是为什么不能用普通的release()+sleep()替代 Condition Variable;Semaphore 不能在 critical section 中等待 (Deadlock)。
条件变量的操作 (必须持锁者才能执行):
-
Wait(&lock):原子地释放 Lock 并进入等待;返回前重新获取 LockThread A:acquire(mutex) → 检查条件 → xxx 条件不满足 cond_wait(&xxx) → 原子释放 mutex 并进入相应条件的等待队列 → BLOCK → 被 cond_signal 唤醒 → 等待重新获取 mutex → 获得锁后 cond_wait() 返回,继续执行
⚠️ 因此有一个非常重要的性质:
cond_wait()返回时,调用线程已经重新持有 Lock。不需要再获取锁,否则对普通的非递归 Mutex,可能造成自己等待自己释放锁的 Deadlock。 -
Signal():唤醒一个等待线程(如果存在)cond_signal(&xxx)表示如果有线程正在等待 xxx,唤醒其中一个,不保证出队顺序!唤醒谁由实现和调度策略决定。若没有等待线程通常不会留下任何通知或值。 -
Broadcast():唤醒所有等待线程cond_broadcast(&xxx)唤醒所有等待 xxx 的线程,但它们仍需重新竞争获得一个 Mutex。
Infinite Synchronized Buffer
通过 Monitor 实现无限容量缓冲,那么 Producer 永远不需要等待空位,Consumer 仍然需要等待数据。因此我们只需要一个 Condition Variable,它对应 Semaphore mutex。
Lock buf_lock;    // 保护 Queue 的锁
Condition buf_CV; // 等待 Queue 非空的条件
Queue queue;

Producer(item) {
    acquire(&buf_lock);    // 获取 Lock
    enqueue(&queue, item); // 添加数据
    cond_signal(&buf_CV);  // 通知正在等待数据的 Consumer
    release(&buf_lock);    // 释放 Lock
}
Consumer() {
    acquire(&buf_lock);
    while (is_empty(&queue)) cond_wait(&buf_CV, &buf_lock);
    item = dequeue(&queue);
    release(&buf_lock);
    return item;
}
⚠️ 为什么不用 if (is_empty(&queue))?
它们最关键的区别是执行 signal() 后,被唤醒线程能否立即获得 Monitor 的执行权——检查一次还是每次醒来都再检查一次?而这取决于调度的类型。
-
Hoare Monitor:当一个线程执行
signal(),等待线程立即获得 Monitor,实现需要复杂的执行权交接机制,但可以使用 if/while 逻辑if相当于条件成立就等待一次,醒来后不再检查 -
Mesa Monitor:执行
signal()的线程不会立即让出 Mutex,被唤醒的线程只是进入 Ready Queue,等待未来被调度 (期间其他线程也可竞争锁),只能用 while 逻辑⚠️
while**不是 Busy Waiting!**相当于每次条件不满足,线程都会通过cond_wait()释放锁并阻塞。每次醒来都重新检查,若条件仍不满足,就继续睡眠Mesa Monitor 的 Signal 只表示某个条件可能已经发生变化,不保证被唤醒线程真正运行时条件仍然成立。
大多数操作系统采用 Mesa-style scheduling
Bounded Buffer with Monitor
这次不使用三个 Semaphore,而是三个 Monitor 来构建有限缓冲同步区
Lock buf_lock = <initially unlocked>;
Condition is_not_full  = <initially empty>;
Condition is_not_empty = <initially empty>;
// 等待队列初始为空,不是指条件值为 false
Producer(item) {
    acquire(&buf_lock);
    while (buffer_full) cond_wait(&is_not_full, &buf_lock);
    enqueue(item);
    cond_signal(&is_not_empty);
    release(&buf_lock);
}
Consumer() {
    acquire(&buf_lock);
    while (buffer_empty) cond_wait(&is_not_empty, &buf_lock);
    item = dequeue();
    cond_signal(&is_not_full);
    release(&buf_lock);
    return item;
}
这比 Semaphore 版本更加直观,条件判断部分直接表达:
P:当 Buffer 满时,等待 Buffer 不再满;C:当空时,等到不再空。
cond_wait() 让线程原子释放 Lock 并进入等待,所以其他线程可以进入临界区,这就避免了使用普通 Mutex 时的 Deadlock。
Mesa Monitor Conclusions
等待某个条件:
acquire(&lock);
while (need_to_wait) cond_wait(&CV, &lock);
// Access or modify shared state
release(&lock);
改变状态并通知其他线程:
acquire(&lock);
// Change shared state
cond_signal(&CV);
release(&lock);
最重要的三个规则:
- 检查共享条件时,必须持有对应的 Lock,否则检查条件与进入等待之间可能出现 Race Condition
cond_wait()会自动释放 Lock,并在返回前重新获取 Lock,可在临界区中等待其他线程改变共享状态- 使用
while重新检查条件,而不是假设被 Signal 后条件一定成立,Mesa 不保证被唤醒线程立即执行
⚠️ Semaphore 的 V() 和 Condition Variable 的 Signal 并不等价:因为信号量通过计数保存许可,而管程不保存通知。如果
signal()执行时无等待者,通知就会丢弃;后来的cond_wait()不会因为之前执行过signal()而返回。因此条件变量必须与一个受 Lock 保护的共享状态条件 while 配合使用。
Readers-Writers Problem
相比上一部分的 Producer-Consumer,读者-写者问题的并发同步逻辑更复杂
对于一个共享数据库,存在两类线程:
- Reader 读者:只读取数据,不修改
- Writer 写者:可以读取并修改数据
只用 Mutex 可以解决这个问题……但这种方案有一个明显的缺点——无限制互斥:多个 Reader 都只读,但它们也无法同时访问,时间复用率 (multiplexing) 低。
三条 Correctness Constraints:
① Reader 可以在没有 Active Writer 时访问数据库 (读者间不互斥)
② Writer 只能在没有 Active Reader,也没有 Active Writer 时访问数据库 (写者全局互斥)
③ 同一时间只有一个线程可以修改同步状态变量
四个 state variables 状态变量 (受锁 lock 保护):
int AR = 0;  // Active Reader
int WR = 0;  // Waiting Reader
int AW = 0;  // Active Writer
int WW = 0;  // Waiting Writer
Lock lock;  // 保护状态变量
Condition ok_to_read - NIL;  // 等待读的队列
Condition ok_to_write = NIL; // 等待写的队列
⚠️ 通常采用 Writer Priority (写者优先) 策略,即当已经有 Writer 正在等待,新 Reader 也必须等待。否则可能发生 Starvation:Reader 源源不断,Writer 被掐死无法执行的情况
因此,Reader 的等待条件不是 AW > 0 而是 AW + WW > 0 ——
Reader() {
    acquire(&lock);
    while ((AW + WW) > 0) {
        WR++;
        cond_wait(&ok_to_read, &lock);
        WR--;
    }
    AR++;
    release(&lock);
    // 读数据库
    access_database(read_only);
    acquire(&lock);
    AR--;
    if (AR == 0 && WW > 0)
        cond_signal(&ok_to_write);
不需要在整个数据库读取期间一直持有 Mutex,这样才能允许多个 Reader 同时读取数据库。但前提是 Reader 只读,Writer 也必须遵守同一套访问协议,否则仍然可能出现数据竞争。
Writer:AW 保证 Writer 之间的互斥,而 WW 用于实现 Writer Priority ——
Writer() {
    acquire(&lock);
    while ((AW + AR) > 0) { // Writer必须独占数据库
        WW++;
        cond_wait(&ok_to_write, &lock);
        WW--;
    }
    AW++;
    release(&lock);
    // 写数据库
    access_database(read_write);
    acquire(&lock);
    AW--;
    if (WW > 0)       // 优先写
        cond_signal(&ok_to_write);
    else if (WR > 0)  // 无等待写者才可以开放读
        cond_broadcast(&ok_to_read);
    release(&lock);
}
-
Readers 可能发生 Starve 吗?因为使用 Writer Priority,假设写者不断到达,就永远无法读——写优先并不等于 Fairness,只是避免 Writer Starve。
-
如果删除 Reader 退出时的
AR == 0判断?通常不会直接破坏互斥正确性,因为 Writer 有while(AR+WR > 0)保护。但造成不必要的唤醒、锁竞争和上下文切换。 -
如果把给 write 的
signal()改成broadcast()?正确性通常仍然可以维持,但会产生不必要的唤醒和锁竞争,这类现象称为 Thundering Herd (惊群)。 -
如果只用一个条件变量 ok 而非分别处理读写?问题是 signal 不保证唤醒哪一种线程,可能导致系统没有线程继续推进,就必须用 broadcast 让所有等待线程重新检查自己的条件。代价是更多不必要的唤醒,不如两个条件变量高效清晰。
-
为何没有 R/W Race Condition:读者的
AR++和写者的AR==0是在同把锁保护下执行的,不可能出现 Reader 认为已经获得读资格,同时 Writer 认为没有任何 Reader 正在读的可能。
Concurrency Programming Tips
C 语言
异常或提前返回时容易忘记释放 Lock:
acquire(&lock);
if (error) return -1;
release(&lock);
- 发生错误时不能直接退出函数,必须确保每条退出路径都释放 Lock。
- 必须 catch 关键区域 (Mutex 区域) 的所有 exception
acquire(&lock);
try {
// ...
Func()
} catch (…) {
release(&lock);
throw;
}
void Func() {if (exception) throw Exception; // ...}
C++
#include <mutex>
std::mutex global_mutex;
int global_i = 0;
void safe_increment() {
    std::lock_guard<std::mutex> lock(global_mutex);
    // 自动获取 Mutex
    global_i++;
}
当函数结束、离开作用域或发生异常导致栈展开时,lock_guard 的析构函数 destructor 会自动释放 Mutex
所以不需要手动写 global_mutex.unlock();。
Python
import threading
lock = threading.Lock()
with lock:
    shared_value += 1
with 关键词自动获取 lock,离开代码块时自动释放 release();即使代码块中发生异常,也会执行相应的退出清理操作。
Java
class Account {
    private int balance;
    public synchronized void deposit(int amount) {
        balance += amount;
    }
}
synchronized 方法会获取对应对象的 Monitor Lock,同一个对象上的其他 synchronized 实例方法,需要竞争同一把锁。
Java 还提供 wait();、notify();、notifyAll(); 对应 Monitor wait、signal、broadcast。
⚠️ Java 的 wait() 也会释放对应对象的 Monitor Lock,并在返回前重新获取。
CSC3150 Lecture9 现代计算机系统的并发
与很多学科不同,计算机科学的重要研究成果经常首先发表在顶级会议而不是期刊,OS 相关的比如 SOSP、OSDI、ATC、EuroSys…
Concurrency Issues Today
之前学习并发时主要考虑多线程共享数据的 Race Condition,真实软件中的并发 Bug 更复杂。
Atomicity Violation (原子性违反):如果两个修改必须作为一个整体执行,那么就应当保护整个操作序列;但使用 Mutex 仍然可能有违反,锁只保证它所保护的操作互斥,Critical Section 的边界必须覆盖所有需要共同保持原子性的操作。
Order Violation (执行顺序违反):OS 调度器不保证两个线程按程序员希望的顺序执行。不能简单的用 sleep(),常见解法是 Monitors-Condition Variable。
RaceBench (CCS 2023) 在真实程序自动注入可触发并发 Bug,用来测试并发分析工具。真实并发 Bug 往往很难稳定复现,RaceBench 会先记录 Execution Trace 即多线程交错情况再进行 Bug Injection。
- 注入代码分为:Prologue 设置 Bug 所需的状态、Precondition 判断是否满足触发条件、Bug Core 执行可能产生并发错误的操作。可稳定复现。
- 结果:Bug Injection Time:生成和注入 Bug 时间;Runtime Overhead:注入 Bug 后运行速度受多大影响。
Machine Learning Parallelism
如何利用并发/并行加速神经网络训练?
一个简单的神经网络可以表示为:每一层执行计算,并将结果传给下一层。

训练神经网络的目标是调整模型参数,使预测误差尽可能小:Gradient Descent Wt+1 = Wt - α∇ f(Wt),优化目标:从 W0 开始找到最小 f(W)。
当模型和训练数据非常大,单 GPU 无法高效完成任务,因此需要 Parallelism。
Data Parallelism:
每个 GPU 保存一份完整模型,但处理不同的数据,计算自己部分的梯度并聚合,更新模型。虽然多个 GPU 可以并行处理数据,但都需要参与梯度同步,模型越大梯度通信越昂贵,因此主要瓶颈是 Communication Overhead (通信开销)。
Model Parallelism:
模型较深时,可把模型拆成多个部分 (多层子神经网络),分配给不同 GPU。因为 GPU 间要等前几层的输出,所以可能出现大量 Idle Time,GPU 利用率低。
PipeDream — Pipeline Parallelism for DNN Training
PipeDream (SOSP 2019) 的核心思想:结合数据并行、模型并行和流水线调度,让多个 GPU 尽可能持续工作,提高模型训练速度,⚠️ 减小传输开销,增加硬件资源利用率。
模型训练的一次迭代过程:Forward Passing 将输入逐层计算输出预测结果,计算 Loss Function 误差;Backward Passing 反向传播计算 Loss 对模型各层参数 W 的梯度然后梯度更新模型参数
回忆 CPU Pipeline 让不同指令同时处于不同阶段重叠执行。
PipeDream:对于 Model Parallelism,当 GPU 1 处理完 Batch 1,并把结果交给 GPU 2 后,GPU 1 不必空闲立即处理 Batch 2……⚠️ 速度约数据并行 5.3 倍。
Pipelining in Deep Neural Network Training ≠ Traditional Pipelining:
- 不同阶段 (神经网络层) 计算时间不同,最长阶段是瓶颈 (影响吞吐 Throughput),需要 Load Balancing 负载均衡
- Forward 和 Backward 的方向相反,同个任务须先完成 Forward 计算才能进行 Backward 计算,因此不能把所有任务都按同方向送入流水线
- 模型参数在训练过程中发生变化,Forward 和 Backward 使用的参数版本可能不同,造成梯度计算不一致
Pipeline Partitioning & Load Balancing
整个流水线的处理速度受到最慢阶段的限制,目标:
- Balance Computation:让各阶段计算时间尽可能接近以减少 GPU 等待
- Minimize Communication:减少阶段之间的数据传输时间。某些层间可能需要传输大量中间结果,所以 ⚠️ 最优划分不一定是每个 GPU 分配相同数量的层,需结合考虑负载与通信
Stage Replication:在某较慢 Pipeline Stage 引入 Data Parallelism,让多 GPU 处理这个阶段的不同的数据
Profiler 性能分析器:测量模型各部分的计算与通信特征
Optimizer 优化器:结合硬件约束,决定如何划分 Pipeline Stages、每个 Stage 分配多少 GPU、平衡计算与通信成本。
1F1B Scheduling
如果连续执行 Forward 再逐个处理其 Backward 会导致 Backward 需要使用 Forward 产生的中间结果 Activations。如此就需要保存大量中间结果。
One Forward, One Backward:Worker 交替执行前向传播和反向传播。不要求每次执行完 Forward 就立即 Backward,而是让 Worker 在不同任务的 Forward 和 Backward 之间交替工作。
Weight Stashing
⚠️ 每次 Backward 完成后会更新模型 W,导致还未完成的 Backward 参数与其对应 Forward 不一致,出现 Weight Version Mismatch —— 模型参数版本不一致会破坏梯度计算的正确性
Weight Stashing:为尚未完成 Backward 的 batch 保存其 Forward 所使用的参数版本;
代价:如有多个尚未完成 Backward 的批次,明显增加显存占用—— Memory-for-Correctness Tradeoff 内存-计算一致性权衡
- 为什么增加 Micro-batch 数量不能消除 Stage 3 的瓶颈?
可以增加填充和排空效率 (减少 Bubble),但不能改变瓶颈造成的吞吐量上限。正确优化方法是 Stage Replication (DLP) 或 Stage Repartitioning (尽量均分阶段)
- 为什么 1F1B 可以先执行 batch 5 的 Forward,再执行 batch 2 的 Backward?不违反计算依赖吗?
不同 Micro-batch 的 Forward 和 Backward 可以交错执行,只要每个 Micro-batch 自己的计算依赖得到满足 (weight stashing!)。不是所有任务间都存在严格先后关系。
- 为什么 Weight Stashing 能保证梯度计算一致性,却不能保证所有 batch 都使用最新参数?
Weight Stashing 保证同个前后向计算有相同 W 版本,而不是所有 batch 使用相同或最新的权重版本。
Other Parallelisms
Pipeline Parallelism 拆分 Layers,Tensor Parallelism 拆分 Layer 内部的计算:将同一层内部同一数据的矩阵运算拆分到多个 GPU 上执行 (两个 GPU 就能并行计算同一个神经网络层)
Expert Parallelism 主要用于 Mixture of Experts (MoE,混合专家模型),普通神经网络让输入经过固定的网络结构;MoE 则包含多个 Expert 专家子网络 (分布在多个 GPU 处理),一个 Router 根据输入决定使用哪些 Expert,将 Token 发送到不同 GPU,并收集 Expert 的输出。
LLM: DistServe
从神经网络的 Training 转向 Inference 推理。
LLM 推理的两个阶段:
Prefill 预填充阶段
假设用户输入:
“请详细解释什么是 Operating Systems,以及它们如何管理 Memory、Process 和 Threads。”
这段 Prompt 包含多个 Tokens,模型首先并行处理整个输入序列,计算各层的中间表示,并建立后续生成所需的 KV Cache。
其特点是:
- 一次处理多个输入 Tokens;
- 计算密集,包含大量矩阵运算;
- 通常具有较高的计算并行度。
指标 TTFT:Time To First Token 从请求到达服务系统到第一个输出 Token 产生所经历的时间。TTFT 越低,用户越快看到模型开始回答
Decoding 解码阶段
Prefill 完成后,模型开始逐个生成输出 Token。Token 1:操作、Token 2:系统、Token 3:是、Token 4:一种……
在标准自回归逐步生成式推理中,每一步生成都依赖之前已经生成的 Tokens。无法简单地把同一个请求的所有输出 Tokens 完全并行生成,但不同请求的 Decoding 可以通过批处理并行执行。所以解码阶段更易受到显存带宽限制。
指标 TPOT:Time Per Output Token 每个输出 Token 的平均生成时间,不包含首 Token 的等待时间。
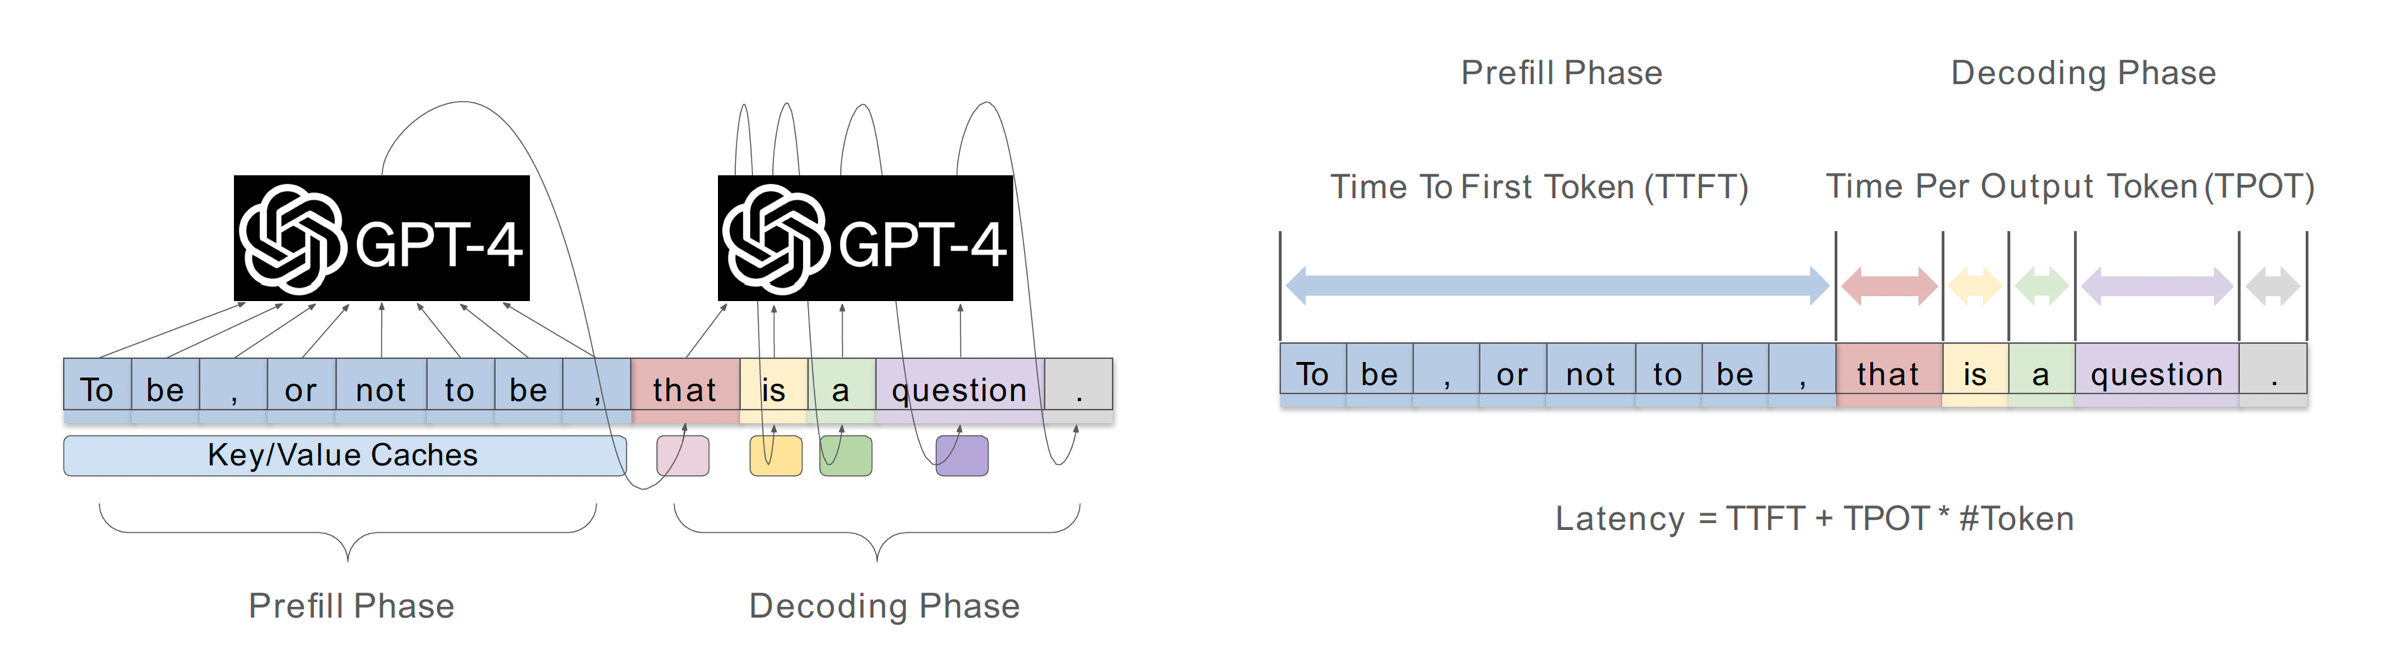
Disaggregting Prefill and Decoding:传统 LLM Serving 系统可能让同组 GPU 同时承担 Prefill 和 Decoding 这两种具有不同计算特征的任务。这会导致:Prefill 干扰 Decoding,增加 TPOT;反之正在运行的 Decoding 也可能影响新请求的 Prefill 调度,使 TTFT 增加。
- DistServe 将 Prefill 和 Decoding 分配给不同的 GPU 资源池,但 Prefill 完成后,必须将 KV Cache 传输给 Decoding GPU。若 KV Cache 大/网络带宽不足,传输开销可能抵消分离带来的收益,DistServe 综合考虑计算资源分配、KV Cache 传输和服务延迟要求。
CSC3150 Lecture10 Scheduling Basics
Basic CPU Scheduling
Scheduling 调度:OS 决定哪些线程在什么时间获得资源使用权 (并将其从 ready queue 退队)
Scheduler 主要决定 READY 与 RUNNING 的转换;不过线程由于 I/O、Lock、Condition Variable 等因素 BLOCKED 后调度器也需要选择其他可运行线程。
程序通常在 CPU Burst (线程连续使用 CPU 进行计算的一段时间) 和 I/O Burst (线程执行 I/O 操作并等待完成的阶段) 之间交替执行。
-
CPU Burst 的长度分布通常偏向较短的 Burst;且经常可能被打断 (preemptive scheduling) 因此线程连续占用 CPU 的时间不一定等于其自然 CPU Burst 长度。
-
⚠️ 不是每次
read()必然 Block,例如数据在缓存中时操作可能很快完成。 -
⚠️ I/O Burst 不意味着 CPU 不参与 I/O,只是线程不占 CPU,但系统调用本身仍需 CPU 执行 Kernel 代码
反之 CPU-Burst 也不是完全不执行 I/O。
Scheduling Policy Goals:
-
Minimize Response Time:最短响应时间 (从任务开始到系统首次响应的时长)
-
Maximize Throughput:最大吞吐率 (单位时间内完成的任务数量)
响应时间最小化可能通过更频 Context Switching 却降低系统吞吐量——⚠️ 两者不一定正相关
吞吐率最大化通常包括 1、缩小 overhead (e.g. context switching);2、提高硬件使用效率/复用率 (CPU, disc, mem etc.)
-
Fairness 公平性:不同线程或用户应以某种合理/公平的方式分享 CPU,比如防止某线程极端 Starvation。
更短响应时间通常导致系统更不公平
Some Scheduling Schemes ——
First-Come First-Served (FCFS) scheduling
FCFS 调度算法也叫 FIFO 或 Run Until Done,相当于先到 (Ready Queue) 先得 CPU,典型的 ⚠️ 非抢占式调度 Non-preemptive (不存在 Timer 打断)
- 在早期系统中被调度的线程会运行到终止,无视 I/O 等待;
- 现在一般指占有 CPU 直到 Terminate、Block 或 Voluntarily Yield。
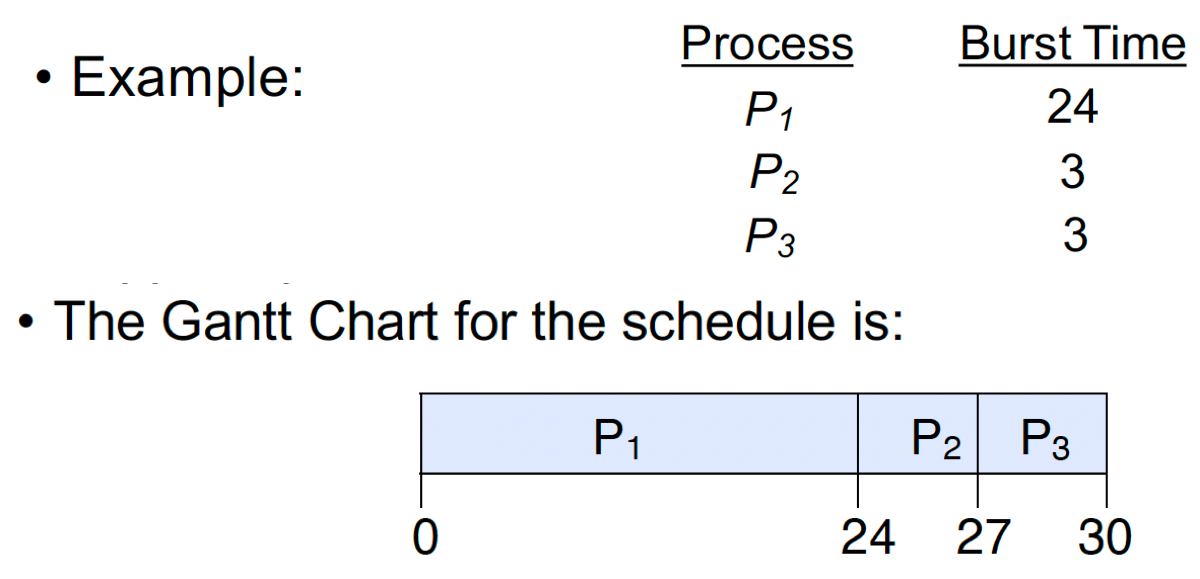
Waiting Time = Completion Time - Burst Time:平均等待时间为 (0+24+17)/3 = 17 平均完成时间点为 (24+27+30)/3 = 27 ——发生了 FCFS 典型缺点:Convoy Effect (车队效应):多个短 CPU Burst 的线程被迫等待前方长 CPU Burst 的线程,导致等待时间增加、系统资源利用率下降。
去你的“护航效应”,你这唐 B 翻译去跟“套接字”一起吃达份去罢
- 优点:实现简单、无需复杂优先级计算、无 Timer 抢占带来的频繁切换 (Throughput ↑)
- 缺点:Convoy Effect (Throughput ↓)、对短任务不友好 (Fairness ↓)、平均等待时间高度依赖任务顺序
Round Robin (RR) scheduling
RR 调度法在 FCFS 的基础上给每个线程分配固定长度的 CPU 时间片 q (Time Quantum) 限制其最多连续执行上限,若在 q (ms) 内未 Block/Terminate/Yield,则⚠️ 触发 Timer Interrupt:Thread RUNNING → READY 然后入队到 Ready Queue 末尾。
-
对于宽 n 的 Ready Queue,⚠️ 没有线程等待时间 > (n-1)/q ms。
-
所以 RR 是一种基于定时器的抢占式调度 ⚠️ Timer-based Preemptive Scheduling
Kernel 实现 RR = FIFO Queue + Timer Interrrupt + Synchronization
-
⚠️ Quantum 太大 → RR 逐渐接近 FCFS (Response Time ↑);Quantum 太小 → Context Switch overhead 增加 (Throughput ↓)
-
平衡响应时间与吞吐量:Quantum 通常设在 10-100ms;Context Switching Overhead 约 0.1–1 ms,占总时长 1% 左右
优点:对短任务更友好 (Fairness ↑);缺点:长任务 CPU 有更多时间花在 Context Switching 上。
RR 不一定比 FCFS 更好:如果所有任务长度相同/相近,RR 让所有任务都接近最后时刻才完成;而 FCFS 可以较早完成前几个开始的任务。
RR 更公平,并不意味着它能最小化 Average Completion Time