💻 CSC3150 Week 4 Concurrency & Synchronization
Lithos
CSC3150 Lecture6 Concurrency
⚠️ Threaded programs must work for all interleavings of thread instruction sequences.
Revision of Threads
回忆 Thread……
多线程并发的速度和资源复用的优势隐含着 race condition 的风险。
线程共享但内存需同步,进程独立但共享需通道。Tradeoff: protection vs. sharing
⚠️ 易混淆概念:
- Multiprocessing:多进程就是多 CPU (多处理器),意味着并行 (parallelism)
- Multiprogramming:多个任务/进程共用 CPU,单核可行,代指并发 (concurrency)
- Multithreading:进程含有多个线程,不保证并行或并发/单核或多核,仅描述程序组织方式。
依旧老生常谈的非原子操作 (non-atomic op.) —— 自增 (increment) 的例子:
pthread_t tid[2];
int counter = 0;
void *do_something(void *arg) {
    for (int i = 0; i < 1000; i++) counter += 1;
    return NULL;
}
int main(void) {
    pthread_create(&(tid[0]), NULL, &do_something, NULL);
    pthread_create(&(tid[1]), NULL, &do_something, NULL);
    pthread_join(&(tid[0]), NULL);
    pthread_join(&(tid[1]), NULL);
    printf(“Counter %d\n”, counter);
    return 0;
}
⚠️ 只有 global/static 变量会发生 race,因为它们处于同个进程中共享的堆上!比如 for 循环条件中的自增项 i 就在两个线程各自的栈上,不会冲突。
两个线程自增同个 counter 变量各 1000 次,但结果不必是 2000,每次运行都可能结果不一。+= 1 的本质是三个汇编命令:
LOAD counter → regn
ADD  regn, 1
STORE regn → counter
Scheduler 在切换时可能发生诸如以下的情况:
< Thread 1 >                   < Thread 2 >
... ...
load counter → r1
r1 = 5
           context switch →
                               load counter → r2
                               r2 = 5
                               r2 = r2 + 1
                               r2 = 6
           ← context switch
r1 = r1 + 1
r1 = 6
store r1 → counter = 6
           context switch →
                               store r2 → counter = 6
在线程写回前切换,发生了 Lost Update。理论上,以上代码运行结果很可能小于 2000,在极端交错下甚至可以落在 1~1000。
Concurrency 的核心是:
多个 execution sequences 的执行可能交错 (interleave) —— 单核也可以错。所以多线程需要 synchronization (同步机制) 协调,例如 mutex、semaphore、atomic operation 等。
Non-deterministic Interleaving:因为 threads 没有彼此隔离,而且共享 address space,scheduler 可以产生不同的 interleaving。线程内有顺序,但线程间没有自动规定顺序。
如此,程序结果依赖多个并发执行之间不可控的 timing / interleaving —— Race Condition
Tradeoff of Threads
为什么明知有风险还要线程?
处理庞大数据流时,如 ATM server、enrollment system、public database…如果只有一个 sequential execution,CPU 大量时间被浪费。即使只有一个 CPU,仍希望 overlap I/O & computation。
-
如果不用线程,必须写成 Event-driven Style,即循环检测事件以触发对应操作。效率尚可,但程序逻辑被打碎 (deconstructing into non-blocking fragments),对开发者不太友好。
-
如果使用线程,程序员仍然可以用非常自然的 sequential code,OS scheduler 负责切换。所以 Threads 给我们:Sequential Programming Model + Concurrent Execution。
以银行 ATM Server 为例,每个 request 都作为一条线程,保持自身内部顺序逻辑,同时彼此 overlap。
while (TRUE) {
    receive_request(...);
    START_THREAD(
        process_request(...)
    );
}
由于线程的 race condition,两个人同时向同个账号汇款可能导致信息覆盖。不是说线程本身危险,而是 并发和共享可变数据 本身就潜在风险。
Atomic Operations
原子操作:只能一次性执行到底或完全不开始执行的指令 (集)
-
不可分割——其内部对外部不可见 (invisible),便不能在中间截断
-
没有原子操作,线程无法安全合作
-
大部分机器上记忆的按字读写 (word-sized load, store) 都是原子操作。
word:4B on 32b machine, 8b on 64b, etc.
很多指令都不是原子的:“i = i + 1”、双精度浮点 (d-fp) store、VAX/IBM360 拷贝数组的命令…
Mutex and Locks
多线程代码必须适应所有 Interleaving 情况结果 (non-deterministic)
-
Synchronization:使用原子操作以协调多线程执行
-
Mutual Exclusion (Mutex):一种特殊的 synch.,某件事情同时段只能一个线程做,用于保护关键代码段
-
Critical Section:同时段最多允许一个线程执行的代码区域 (互斥 Mutex 保护的对象)
-
Lock:同时段只能由一个线程持有的 object,用于实现 Mutex。提供给线程两个原子操作 API——
lock.acquire(&lock):等 lock free 后,调用该指令的线程占有 lock (hold the lock),.acquire尤其必须是 atomic —— 检查锁状态和上锁必须不可分割,否则多个线程都可能“抢到锁”。lock.release(&lock):占锁的线程调用以释放 lock。在 CS 前后加 lock 指令使后续线程无法打断正在执行的线程。因此不会 overlap。
Lock 的初始化:
pthread_mutex_t lock;
pthread_mutex_init(&lock, NULL);
比如 ATM 存钱问题…
pthread_mutex_t lock;
pthread_mutex_init(&lock, NULL);
deposit(acctId, amount) {
    acquire(&lock);
    acct = get_account(acct_id); //
    acct->balance += amount;     // Critical Section
    store_account(acct);         //
    release(&lock)
Designing of Locks
检查锁状态和上锁必须不可分割,否则多个线程都可能“抢到锁” —— 比如检查有没有牛奶和留下“我去买了”纸条必须同时完成,不然第二个人可能在第一个人贴纸条前认为自己没看到纸条,然后也去买了。
-
如果不是原子操作,这个锁的方案会使问题更糟,因为无法确定哪次会失败 (fails intermittently) ——不可知性比必然失败更恶心。
- “不确定是否安全还不如绝对不安全”
-
那如果我们先“留纸条” (声明上锁) 在“检查有无牛奶” (检查锁状态) 呢?呃…对于人类这个逻辑可能很清晰,但人机计算机 (字面意思) 就100% 不会运行 Critical Section了,因为检查时永远被自己上锁了…
- “
你就说绝对无法运行安全不安全吧”
- “
-
如果先留纸条且署名呢?如果有纸条但不是我写的纸条就不买?那很谦让了:
A:“I’m not getting milk, you’re getting milk.”
B:“You said you are going, I’m not getting it"
A:”But you also said you’re buying milk, so I shouldn’t"
……
starvation, what a way to dieA 声明上锁后切到 B 上锁,完了,谁也没法运行 Critical Section 了。
- “安全但可能无法运行,这种最阴了”
-
多边不对称解法
A:如果有 B 纸条:你想买?好,我等你。
B:如果有 A 纸条:你想买?好,我不买了。
相当于人为规定冲突时 B 让 A:
leave note_A;           leave note_B;
while (note_B) { <----> if (no_note_A) {
    do nothing              if (no_milk) {
}                               buy_milk();
if (no_milk) {              }
    buy_milk();         }
}                       remove note_B;
remove note_A;
为何这正确?假设 Sequencial Consistency:There is a single, global order of loads and stores, and operations issued by each thread are processed in program order 即每个线程确定自己内部的执行顺序不能乱
-
在这个前提下,线程不发生乱序执行,不考虑现代编译器/调度器的 ordering。
-
如果 A 先留纸条,B 就会撕掉纸条让 A 干,如果 B 先看有没有纸条早于 A 留纸条,B 就不会撕纸条,A 就只能等 B 买完牛奶,无论如何,不冲突。
问题是这个不对称解法过于复杂,在现实机器中经常存在成百上千条多线程,怎么谁记每个线程不同的上锁协议?对代码长度负担太大,且不对称所需的等待会消耗大量 CPU 时间 (⚠️ busy-waiting)。
Leslie Lamport’s Bakery Algorithm (1974) 证明了理论上可以用 shared memory 的读写设计复杂的软件 mutual exclusion protocol…但这太复杂了。
说到底,我们本质上还是想要两个原子操作 API acquire & release 来确保 Synchronization。
CSC3150 Lecture7 Synchronization & Lock
既然 acquire & release 必须是原子操作,是否可以让 CPU (硬件) 直接提供 Lock 指令?
Intel 432 实现了硬件锁,但锁问题涉及 OS Scheduler,且硬件必须知道线程、调度器、锁冲突 (BLOCKED) 集对应等待队列等等对硬件不必要的抽象。硬件复杂度变大,致其变慢。
思路:硬件提供少量 Atomic Primitives,操作系统用它们实现 Lock。
Solution1: Disable Interrupt Lock
从 OS 角度想,既然线程切换会导致操作被打断,那能不能暂时禁止线程切换?
CPU Context Switch 发生于两种情况:
-
Internal Events:线程主动让出 CPU,比如
sleep();、yield();及可能引起异步阻塞的 Syscall;还有 Trap/Exception -
External Events:Timer、I/O Interrupt
那么,在单核 CPU 上,如果当前线程不主动让出 CPU 且 禁止会引起抢占的 Interrupt。就可以连续执行一段指令而不被其他线程抢占——制造一段“多指令原子操作” 实现 Mutex
⚠️ 这只适用于单处理器,因为每个核独立控制 interrupt 开关
回顾 Thread States 线程运行状态:
          NEW THREAD
              ↓
            READY ←────────────────┐
              │ Scheduler dispatch │
              ↓                 interrupt
           RUNNING (正在执行指令)→───┘
              ├───── exit ──────→ TERMINATED (执行结束,不再占CPU)
              │ I/O or event wait,sleep
              ↓
        WAITING/BLOCKED (等待某个事件发生,不占CPU)
              │ event completed/wakeup
              ↓
            READY (可以运行,但等待CPU空出)
BLOCKED 代表即使 CPU 空闲也不能运行 (等待事件);READY 是等 CPU 空闲即有资格运行 (等待调度)
Naive Disable Interrupt
最简单的 No-Interrupt Lock 思路:LockAcquire() {disable_interrupts();}、LockRelease() {enable_interrupts();} —— 直接通过控制是否可打断作为锁钥。
即使假设 critical section 中 Running Thread 不会主动阻塞 (No Syscall),这种实现也有问题:
如果 Critical Section 永远不结束呢?不能把禁用中断这种高权限指令直接当作用户程序的通用 Lock
Disable on Lock-ops
如果只在操作 Lock 时禁用中断,只保护 acquire() 和 release() 中的 critical section:检查 Lock/修改 Lock 部分
int value = FREE;
Acquire() {
    disable_interrupts();
    if (value == BUSY) {
        put_thread_on_wait_queue();
        go_to_sleep();
    } else value = BUSY;
    enable_interrupts();
}
Release() {
    disable_interrupts();
    if (anyone_on_wait_queue()) {
        take_thread_off_wait_queue();
        change_thread_to_READY();
    }
    value = FREE;
    enable_interrupts();
}
Acquire() 中,如果线程已经进入等待队列 sleep,那么谁来执行 enable_interrupts()?
如果在 sleep 前恢复可打断,无论按何种顺序,都会发生 Missed Wakeup:
disable_interrupts();
enqueue(thread);
enable_interrupts();
sleep();
-----------------------------------------------
时间	   Thread A	                Thread B
T1	disable_interrupts()	        Running
T2	enqueue(A)	                     │
T3	enable_interrupts()	             │
T4	发生时钟中断 切换到B                │
T5		                           wakeup(A)
T6		                     发现A在等待队列,将A出队
T7		                           Wakeup 完成
T8	                              A 恢复执行
T9	sleep(),将自己置为 BLOCKED
T10	A睡着了,但已经没有后续 Wakeup
⚠️ Missed Wakeup:唤醒发生时,等待者尚未正确进入等待状态,因此错过了本应唤醒它的事件。
如果先 enable 然后 enqueue+sleep,若发生立刻切换,队列空,甚至连 wakeup 信号都不会发出。
睡眠状态的建立和 CPU 的让出,必须由内核以不会丢失唤醒的方式协调完成——
前线程在中断禁用状态下进入 sleep(),Scheduler 切换到另一个线程负责恢复适当的中断状态……直到某次原线程被唤醒后,从 sleep() 返回,继续执行后面的代码。
disable_interrupts();
enqueue(thread);
sleep();
enable_interrupts();
-----------------------------------------------
Thread A                    Thread B
disable interrupts
sleep()
   └──────────────────────→  resume
    Context Switch      enable interrupts
                               ...
                        disable interrupts
           Context Switch     sleep()
sleep() returns  ←──────────────┘
enable interrupts
UNIX OS 在开机时就会建立 Idle Thread,如果没有其他线程 (全部 blocked),它会被 scheduler 切入让 CPU 等待中断或进入低功耗状态,不做实际业务。Idle Thread 永远不会 BLOCK,永远存在线程帮助下个线程 wakeup。
Solution2: Atomic Read-Modify-Write Lock
disable_interrupts(); 方案有两个明显缺点:
- 用户程序不能直接禁用中断 (用户无法接触 Lock implementation)
- 多核 CPU 上禁用本核中断不能阻止其他 Core
需要更通用的硬件支持:READ-MODIFY-WRITE 不可分,以下为几种原子指令的 C 代码逻辑描述:
Test&Set
int test_and_set(int &address) {
    int result = *address;
    *address = 1;
    return result;
}
这段 C 代码只是语义描述,真正的 T&S 是硬件支持的原子操作,无法用 C load/store 实现
它读取内存中的旧值,把内存设置为 1,然后返回旧值 (0:原来没锁;1:原本已上锁)
Compare&Swap (CAS)
compare_and_swap(address, expected, new_value)
if (*address == expected) {
    *address = new_value;
    return SUCCESS;
} else {
    return FAILURE;
}
IFF 内存保持我预期的状态,才允许修改,这在并发编程中非常有用——CAS 能解决 Race Condition,当不符合预期说明丢失更新 (Missed Update),并触发重新
readCAS 保证不会基于已经过期的预期值错误地覆盖别人的修改,不使用传统 Mutex 协调共享多线程的更新
Swap
void swap (&address, register) {
temp = *address;
*address = register;
register = temp;
}
原子交换指令
Spinlock
无需 Kernel 读写,存在于 userspace 的简单原子自旋锁实现:
int lock = 0;  // Interface: acquire(&mylock); release(&mylock);
void acquire(int *lock) {
    while (test_and_set(lock)) {
        // Busy Waiting
    }
}
void release(int *lock)  *lock = 0;
⚠️ 检查和设置锁状态发生在同一个 Atomic Operation 中,所以两个线程不可能同时通过这一检查
Spinlock 中,等待线程 *lock = 1 一直循环 while (T&S),不会主动进入 Blocked 状态,这种等待方式叫 Busy Waiting
| 特性 | Spinlock | Blocking Mutex |
|---|---|---|
| 等待时线程状态 | 通常仍为 Running/Ready | Blocked |
| 是否持续消耗 CPU | 是 | 不持续消耗 |
| 是否需要睡眠/唤醒 | 不需要 | 通常需要 |
| 适合场景 | 极短临界区 | 可能较长的等待 |
| 主要问题 | 浪费 CPU | 睡眠/唤醒有额外开销 |
每次 T&S 循环都有尝试 write 操作,在多核情况下不仅浪费等待线程的 CPU,还可能增加缓存一致性 (Cache Coherence) 流量,浪费 network bandwidth。
⚠️ 要求设计同步算法时,除非明确允许自旋,否则应优先考虑能让等待线程睡眠的方案,避免 Busy Waiting。
Better T&S Lock
结合前两种方案优点:只在极短的内部操作中使用 Spinlock,真正等待锁的线程进入 Sleep
int guard = 0;
int mylock = FREE;
acquire(int *thelock) {
    while (test_and_set(&guard));
        if (*thelock == BUSY) {
            put_thread_on_wait_queue();
            go to sleep() & guard = 0;
        } else {
            *thelock = BUSY;
            guard = 0;
    }
}
release(int *thelock) {
    while (test_and_set(&guard));
        if (anyone_on_wait_queue()) {
            take_thread_off_wait_queue();
            place_on_ready_queue();
        } else *thelock = FREE;
    guard = 0;
}
-
变量 guard 负责保护 Lock Implementation 本身的 Mutex
-
acquire 的关键是 Sleep 和 Release Guard 必须不可分割地协调完成,不可写成两个独立操作,否则又可能出现 Missed Wakeup
-
release 中若等待队列有线程,并不直接将 mylock 设置为 FREE,因为锁可以直接交给等待线程 (所有权交接时锁保持 BUSY),只有队空时释放锁。这种设计下等待线程不需要一直消耗 CPU 自旋
⚠️ Linux Futex
Futex = Fast Userspace Mutex
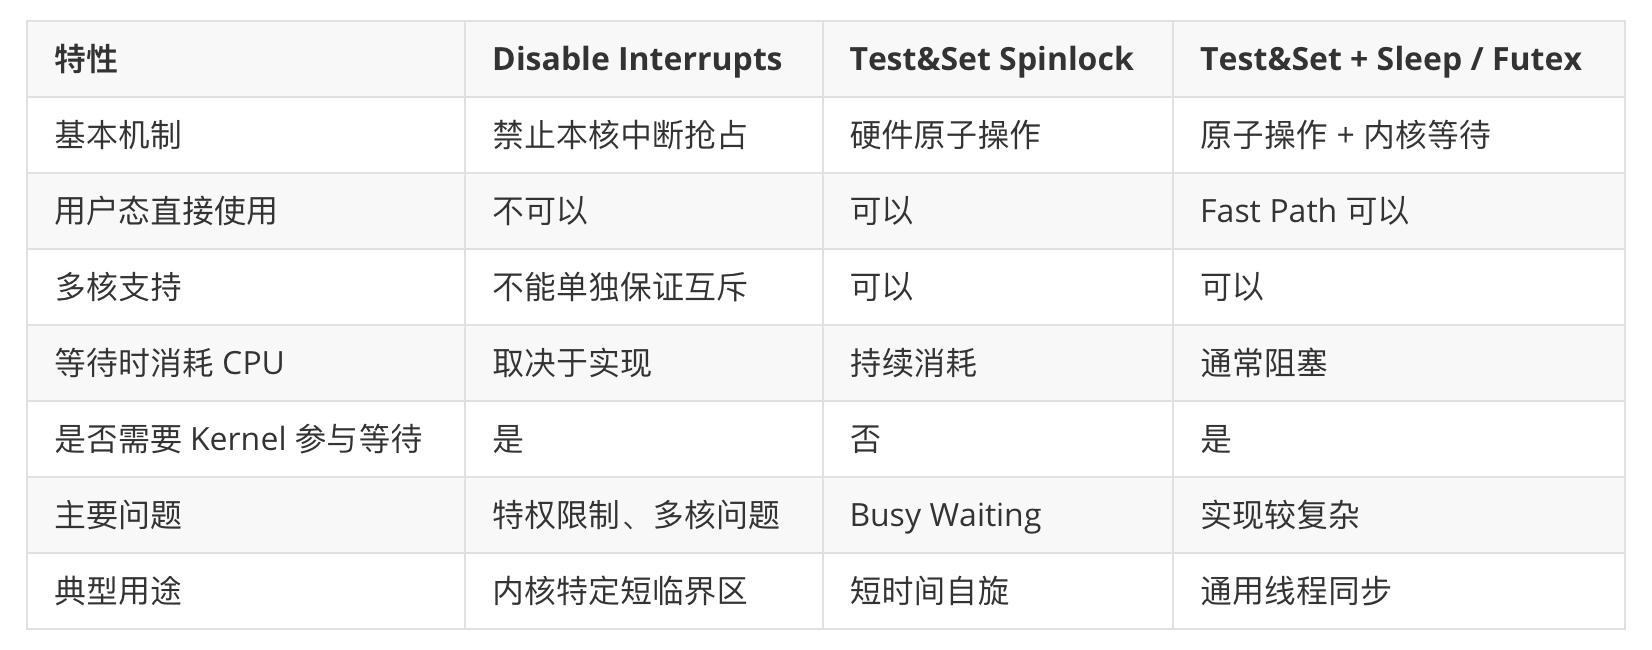
纯 Spinlock 不用进入 Kernel 但等待时持续消耗 CPU;Kernel Blocking Lock 可以 Sleep 但 频繁 Syscall 有额外开销—— Futex 希望 Lock FREE 时在 Userspace 直接获取,Lock BUSY 时进入 Kernel 以 Sleep。
两个重要操作
int futex(int *uaddr, int futex_op, int val, const struct timespec *timeout);
// E.g.
futex(uaddr, FUTEX_WAIT, val, timeout);
futex(uaddr, FUTEX_WAKE, val, ...);
-
uaddr 指向一个 userspace 中的 32-bit 值
-
FUTEX_WAIT:如果
*uaddr仍等于预期值 val 则进入 Sleep 直到 FUTEX_WAKE (为避免 Missed Wakeup) -
FUTEX_WAKE:唤醒最多 val 个等待线程
-
timeout:指向一个 timespec structure 以设置 futex_op 的超时时长的指针
futex 不向 libc 暴露,它被运用于 pthread implementation 中
Futex T&S Lock
int mylock = FREE;
acquire(int *thelock) {
    while (test_and_set(thelock)) {
        futex(thelock, FUTEX_WAIT, 1);
    }
}
release(int *thelock) {
    *thelock = 0;
    futex(thelock, FUTEX_WAKE, 1);
}
- Lock FREE 时,线程没有调用 Futex 就在 userspace 获得锁 (Uncontended Lock → Userspace Fast Path)
- Lock BUSY 时,通过 Futex 控制 Kernel sleep 以排队 (Contended Lock → Kernel Slow Path)
发生竞争时才需要进入 Kernel,所以可以同时获得:无竞争时的低开销、发生竞争时的阻塞等待、无长期 Busy Waiting、支持多核 CPU。但 release 仍需要进入内核,即使实际上没有等待者
实际的 Futex-based Mutex 可以进一步优化,避免大量不必要的系统调用。
Semaphores 信号量
如果一个线程必须等待另一个线程完成某件事,只有 Lock 通常不够
- Programs:使用共享资源。例如多线程应用
- Higher-level API:同步与协调。例如 Locks、Semaphores、Monitors
- Hardware:提供原子操作能力。例如 Load/Store、Test&Set、CAS、Disable Interrupts
Producer-Consumer Problem
-
Producer(生产者):向 Buffer 中添加数据。
-
Consumer(消费者):从 Buffer 中取出数据。
不希望 Producer 和 Consumer 必须严格一对一地交替执行,Buffer 让两者可以以不同速度工作
-
Buffer(缓冲区):生产者和消费者共享的存储空间。只需要保证:
- Buffer 不会溢出,不会从空 Buffer 中取数据。
- 多个线程不会同时破坏 Buffer 的内部状态。
Producer 必须在 Buffer Full 时等待。同样,如果 Buffer 为空 consumer 也不能 dequeue。这就是 Bounded Buffer Problem(有界缓冲区问题)
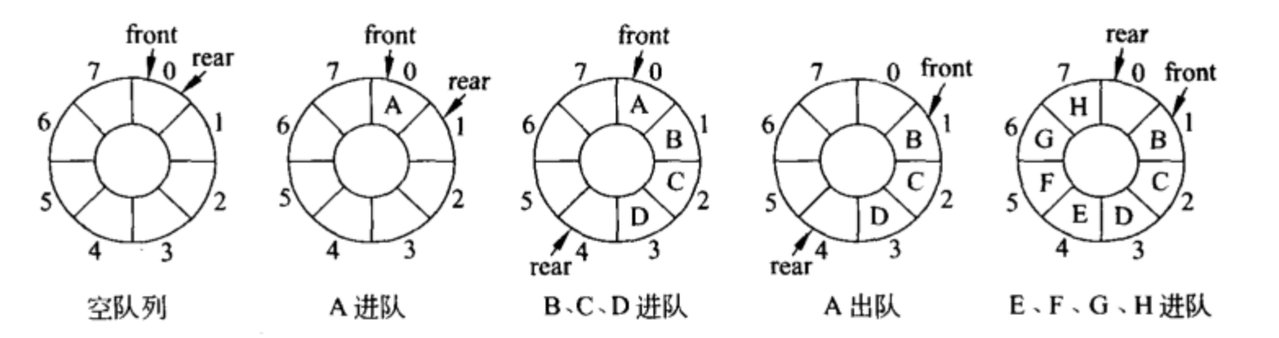
Circular Buffer 循环缓冲区
typedef struct buf {
    int write_index;
    int read_index;
    <type> *entries[BUFSIZE];
} buf_t;
write_index:下一个写入位置read_index:下一个读取位置entries[]:存储数据的数组BUFSIZE:Buffer 的容量
// Producer
entries[write_index] = item;
write_index = (write_index + 1) % BUFSIZE;
// Consumer
item = entries[read_index];
read_index = (read_index + 1) % BUFSIZE;
这里 % BUFSIZE 是为了循环使用数组,比如 BUFSIZE = 4,write_index = 3 时入队,写指针会从最后一个位置 3 回到第一个位置 0
⚠️ 判断 full/empty:read_index == write_index 无法确定是满还是空,一般要维护 count 确定满/空。
Circular Buffer with Lock
Mutex buf_lock = <initially unlocked>;
Producer(item) {
    acquire(&buf_lock);
    while (buffer_full) {}
    enqueue(item);
    release(&buf_lock);
}
Consumer() {
    acquire(&buf_lock);
    while (buffer_empty) {}
    item = dequeue();
    release(&buf_lock);
    return item;
}
- Producer 操作 Buffer 前先获取锁。
- Consumer 操作 Buffer 前也先获取锁。
- 保证同一时间只有一个线程操作 Buffer。
⚠️ 但实际上存在严重问题:假设 Buffer 已满,Producer 获得锁并 busy wait 缓冲区出现空位,但需要 Consumer 获得锁才能腾出空位,于是形成循环等待 Deadlock,程序可能永远无法继续。
如果改成:
while (buffer full) { release(&buf_lock); acquire(&buf_lock); }
while (buffer empty) { release(&buf_lock); acquire(&buf_lock); };
那么这样 Consumer 就有机会获取 Lock 并消费数据,因此之前的循环等待被打破了。⚠️ 但是又有新问题:while 仍然在不断尝试,即使 Buffer 长时间没有读写
-
单核下 Producer 可能重新获得锁,Consumer 需要等待调度机会,造成不必要的 CPU 消耗。
-
多核下 Producer 可能在一个 Core 上不断检查,Consumer 在另一个 Core 上工作,产生不必要的锁竞争和缓存一致性开销。
虽然没有 Deadlock 但还存在 Busy Waiting 问题。希望 Buffer FULL 时立即 Producer BLOCK,并切给 Consumer。
Semaphore
Semaphore 信号量 是 UNIX 的一种通用同步原语 (Sync. Primitive),属于一种泛锁。Semaphore 内部有一个非负整数,但它不是普通 int,不能随意修改或读写,只可以:
- 初始化值;
- 通过 Down()/P() 等待 Semaphore 大于 0,然后原子自减 1 (不允许减到负数);
- 通过 Up()/V() 原子自增 Semaphore 的值,并在需要时唤醒等待线程 (比如 P() 在等 >0)。
⚠️ P 和 V 必须是 Atomic Operations,并避免 P() sleep 等待不能 miss V() wakeup
用法一、Semaphore 实现 Mutex:初始值为 1,这种用法称为 Binary Semaphore (二进制信号量)
P(&mutex);  // 相当于获得锁
// Critical Section
V(&mutex);  // 相当于释放锁
用法二、Scheduling Constraints
假设要保证 A 与 B 线程先后有序执行,信号量初始值为 0,后执行者运行 P(),先执行者运行完成后执行 V()。
这就是 Semaphore 的重要特性:处于 0 时,V() 需先于 P() 发生
Semaphore done = 0;
ThreadJoin() {
    P(&done);
}
ThreadFinish() {
    V(&done);
}
即,可以用信号量表达“现在有多少个可用资源”
Bounded Buffer
回到 Producer-Consumer Problem,需要三个 Correctness Constraints 信号量:
- Consumer 必须在 Buffer Empty 时等待
- Producer 必须在 Buffer Full 时等待
- 同一时间只能有一个线程操作 Buffer Queue
前两个是 Scheduling Constraint,后一个是 Mutex
Semaphore full_slots;  //有多少可消费位:初始0
Semaphore empty_slots; //有多少可写入位:初始BUFSIZE
Semaphore mutex;       //Buffer Lock:初始1
Producer-Consumer Solution:
Semaphore full_slots = 0; // 初始为空
Semaphore empty_slots = buf_size;
Semaphore mutex = 1;  // 初始无线程有Lock
Producer(item) {
    P(&empty_slots);  // 申请一个空槽位(如有)
    P(&mutex);        // 获取Buffer Lock
    enqueue(item);    // 将数据放入Buffer
    V(&mutex);        // 释放Lock
    V(&full_slots);   // 宣布增加一个可消费数据
}
Consumer() {
    P(&full_slots);   // 申请一个可消费数据(如有)
    P(&mutex);        // 获取Buffer Lock
    item = dequeue(); // 从Buffer取一个数据
    V(&mutex);        // 释放Lock
    V(&empty_slots);  // 通知Producer多一个空位
    return item;
}
⚠️ P() 顺序不可变:若交换申请位和获得锁,可能出现 Deadlock 循环等待。必须先等待资源可用,再获取保护共享数据结构的 Mutex。
⚠️ 与 P() 顺序不同,交换这两个 V() 的顺序并不必然造成 Deadlock,在正确 Semaphore 语义下也可保持同步正确性,因为 Consumer 即使被唤醒,也仍需要等待 Mutex。但这可能造成不必要的竞争。
Semaphore 相比单纯使用 Load/Store 或 Lock,是很大的进步。因为它可以同时处理:Mutual Exclusion 和 Scheduling Constraints,但问题也正来自这里:Semaphore 有两种不同用途,却使用完全相同的 P/V 接口
仅仅交换两个 P() 就可能造成 Deadlock,这引出了下一讲的主题:Monitors (管程)。