💻 CSC4120 Week 5 哈希与密码学
Lithos
CSC4120 W05 Hashing and Cryptography
I. Key Principles of Hashing
哈希表 是一种直接计算元素应该存在哪里,从而实现平均 O(1) 搜索的 ADT:
| 数据结构 | Search | Insert | Delete |
|---|---|---|---|
| Unsorted Array | | O(n) | | O(1) | | O(1)* |
| Sorted Array | | O(log n) | | O(n) | | O(n) |
| AVL Tree | | O(log n) | | O(log n) | | O(log n) |
| vEB Tree | | O(log log u) | | O(log log u) | | O(log log u) |
| Hash Table | | 平均 O(1) | | 平均 O(1) | | 平均 O(1) |
数组的问题:假设存储来自于 U = {0, 1, 999999} 的 n = 100 个元素,即使数组宽度很短,但如果想 O(1) 查询,用 BitSet 就要 106 个 key,最终仅利用庞大 key universe 的 0.01%,浪费。
哈希函数
Hash Function (哈希函数):将任意大小的输入映射为固定大小的输出值的所有函数
- MD5 哈希函数将所有长度的输入转化为一段 16B 信息;
- 模运算也是哈希函数,桶的个数等于模数 (即除数)
- 甚至如果输入有界 (收敛),Identity Function y=x 也是哈希函数,虽然很差
哈希 h: U → {0,1, … ,m-1},其中 h(k) 表示 key k 的映射结果,m 为桶数 (哈希表 T 的大小)
-
哈希函数结果不必随机,比如模运算可预期且永远一致。
-
哈希函数无需双射 (逐一对应),但希望不同输入尽可能均匀地分散到不同位置:把键映射为尽量不同的整数。
应尽可能避免输入数据的规律造成大量碰撞 (落到同个桶) 导致退化回数组
仅当我们知道所有键时可以设计出完美哈希 (双射)
Mid-square Method
平方取中法是一种简单的整数 key 的哈希方法:
将 key 平方;从结果中截取中间 r bits;将截取结果作为 hash value ∈ {0, 2r -1}
取 d 位就是 {0, 10d -1}
平方比简单取余更好,因为平方运算会使输入中不同位置的数字相互影响。例如,输入高位发生变化,也可能影响平方结果的中间位,因此它可以减轻某些输入规律对哈希分布的影响。不过平方取中并不能保证均匀分布。
非数值键哈希
首先可以将字符转通过 ASCII 编码转为数字,比如 a ≡ 97DEC ≡ 61HEX, A ≡ 65DEC ≡ 41HEX
因此可以把字符串看作一个 base-128 的数字,即,每个字符定长 7-bit
-
E.g.:ABC → 65 x 1282 + 66 x 128 + 67 = 1073475 并使用这个整数键做哈希
-
字符串编码为整数 和 整数映射到哈希表位置 可以合并实现,但概念上不是同个步骤
Hash Collision
冲突不可避免,因为不完美的哈希函数和有限的桶,导致不同 key 被映射到同个桶
根据 Pigeonhole Principle (鸽巢原理):当输入数量 |U| 大于输出位置数量 m 时,必存在 k1 ≠ k2 使 h(k1) = h(k2),称为 Collision (冲突).
C++ std::unordered_map 采用分离链表/链地址法 (separate chaining) 解决冲突,让每个桶保存一条小链表,所有哈希值相等的元素存到链结构中。此时 ⚠️ 哈希表的搜索效率取决于 Collision 导致的链表长度 L:O(1+L) 计算哈希 + 遍历链表
Worst-case Lemma:根据鸽巢原理,对于任意哈希函数 hU→m ,存在一个桶,至少 ⌈|U|/m⌉ 个不同 universal keys 映射到这个桶
如果恶意程序故意挑选这些 key 全部插入哈希表,就会形成长链表,导致 Worst-case Search = O(n)
(⚠️ 这不意味着实际存储的 n 个 key 必然产生这么多碰撞)
2 Types of Randomness Models
虽然 wcc hashing search 为 O(n),但平均 O(1)
这是因为我们引入了概率模型:
- Simple Uniform Hashing Assumption(SUHA)
- Universal Hashing
SUHA
SUHA 假设 Hash Function h 固定,key 随机均匀的从 U 抽取。在此前提下,当 h(k) 结果均匀分布在 {1, …, m} 上,即 $P_k(h(k)=i) = {1\over m},\ \forall i \in {1, …, m}$ 时——
- 我们认为 h 是一个“好”的哈希函数
- h 是伪随机的均匀分布
SUHA 的缺点是它对 key 的分布提出了要求,而实际上往往无法控制用户输入数据的分布
Universal Hashing
Universal Hashing 与 SUHA 正相反,固定 Key,但 h 随机从一个全局哈希函数集合 H 中均匀抽取。在此前提下,当任意两键碰撞的概率不高于 1/m,即 $P_h(h(k_1)=h(k_2)) ≤ {1\over m}\ \forall k_1 ≠ k_2$ 时——
- 我们认为 H 是一个 Universal 的哈希函数集合
- 对于任意两个不同 key,在 H 中最多只有 |H|/m 个函数会让它们发生碰撞。
⚠️ SUHA 和 Universal Hashing 并不等价,但可以得到类似的平均复杂度分析。直觉来说,我们默认使用 SUHA 模型。
Division Method
以 h(k)=k mod m 为例,m 个桶分别对应 |U|/m 个 key。如果从 Universe 随机选 Key,$P_k(h(k)=i) = {1\over m}$,因此 h(k) 满足 SUHA;但如果 key 都是 4 的倍数就不满足
所以一个哈希函数是否满足 SUHA,要结合 key 的概率分布判断。
Multiplication Method
h(k) = ⌊m(kA mod 1)⌋,其中 A = ${\sqrt{5} -1\over 2}$ ≈ 0.618;mod 1 表示取小数部分。
这个方法利用乘法和取小数部分,将 key 分散到不同位置。在实践中,它近似均匀散列,近似 SUHA。
SUHA 概率计算
哈希结果的本质等同于 将 n 个球随机扔进 m 个箱子 的概率问题
Load Factor
将桶 (slot) i 中的元素数量记作 Xi,n = Σω=0m-1Xω,取期望 n = Σω=0m-1E[Xω],每个位置概率均等,故 E[Xi] = n/m = α
所有桶中键的数量 n;哈希表桶的个数 m,⚠️ 装载因子 LoadFactor = ${n \over m} = E[X_i] = α$,就是每个桶平均装了多少键,直接反映了哈希表的拥挤程度。对于链地址法,α 可以大于 1。
Empty Slots
定义指示随机变量 Yi ∈ {0, 1|Y=1 if slot empty, Y=0 if not},所以 E[Yi] = P(slot i 为空) = 1xP(Yi=1) + 0xP(Yi=0) = P(Yi=1)
每个键落进桶 i 的概率为 1/m,反之不落入就是 1-1/m,在键相互独立的前提下 E[Yi] = P(slot i 为空) = (1-1/m)n
⚠️ 所以总共的空位数期望就是 E[Y] = Σi=0m-1E[Yi] = m(1-1/m)n
当 n=m 时 E[Y] = m(1-1/m)m,${E[Y] \over m} = (1- {1\over m})^m$,因为 $\lim_{m → \infty} (1- {1\over m})^m = {1\over e}$ ≈ 36.79%
即使键和桶数量一样多,平均上仍有约 36.8% 的桶为空,36.8% 的桶有一个元素,26.4% 的桶存储至少两个元素,即发生 Collision。
如果要用上所有 m 个桶,先考虑“当有 k 个非空 slots,平均哈希多少个键才进入一个空 slot?”—— 下一次进入空 slot 的概率 pk = (n-k) / n,问题符合 ⚠️ 几何分布:对于成功概率为 p 的几何分布,直到首次成功所需的试验次数的期望为 E[Xk] = 1 / pk = n / (n-k)
所以让所有桶非空需要 T = Σk=0n-1Xk 次,故 E[T] = n/n + n/(n-1) + … + n/1 = n(1 + 2-1 + 3-1 + … + n-1) = ⚠️ nΣi=1n (i-1)。
即让所有桶都至少有一个键的期望为 n x n 的几何级数次哈希,⚠️ E[T] = Θ(nlogn)
n 个球投入 n 个 bins,最拥挤的 bin 有多少球?
X1 ~ Binomial(n, 1/n),P(X1 = k) = ${n \choose k} ({1\over n})^k (1-{1\over n})^{n-k}$,当 n → ∞,使用 Poisson Approx. P(X1 = k) = e-1/k!,Union Bound P(X1 ≥ k) ≤ (e/k)k,P(max{Xi} ≥ k) ≤ n(e/k)k
考虑 n(e/k)k,取对 ln(n) + k(1-ln(k)) 临界位置 ≈ 0,即 k(ln(k)-1) ≈ ln(n),k 大时近似 k = $\ln n \over \ln \ln n$,所以 E[max{Xi}] = Θ($\ln n \over \ln \ln n$)
Universal Hashing: Search
哈希表 T 搜索 Search(k) 需要计算 h(k) 然后遍历 T[h(k)],O(1+L) 其中 L 表示 h(k) 链表长度。
-
Successful Search:假设 k 存在于 T,在 Universal Hashing 下:对于任意 y≠k,P(h(y)=h(k)) ≤ 1/m
对于 k 以外的 n-1 个元素中,与 k 碰撞的期望数量不超过 (n-1) / m
加上 k 本身 E[L] ≤ 1 + (n-1)/m
⚠️ 这是对整条链表长度的界,因此也给出了搜索工作量的上界;实际成功查找可能在遍历完整条链表之前就找到目标
-
Unsuccessful Search:目标不存在时必然遍历 n 个键,即 E[L] ≤ n/m
加上计算 Hash Function 的常数时间:E[T] = O(1 + n/m) = O(1 + α) 当 n 为 m 的常数 c 倍,负载因子 α = c,那么 E[T] = O(1) 常数时间。
当负载因子保持为常数时,在良好的随机性模型下,平均链表长度也是常数,哈希搜索就是常数时间
II. Universal Hashing, String Matching and Table Doubling
如何构造一个满足定义的函数集合 H?
- $P_h(h(k_1)=h(k_2)) ≤ {1\over m}\ \forall k_1 ≠ k_2$
- $|{h \in H : h(k_1)=h(k_2)}| ≤ {|H|\over m}$
Matrix Method
假设一个 key 是 u-bit 2进制表达的整数,u 位可表示 0~2u-1 的自然数。然后可写作列向量,比如 u = 4,k1 = 14 → k1 = [1 1 1 0]T
我们想将它映射成一个 b-bit 的 Hash Value,即哈希表大小 m = 2b。
所需哈希函数 h: {0,1}u → {0,1}b
最符合直觉的做法就是随机生成一个 b x u 的二进制矩阵 H’,⚠️ 定义 hH(x) = H’x mod 2。比如:
取模 2 是因为我们希望输出的每个位置都是一个 bit:0 / 1。而且模 2 加法有一个重要性质 1 + 1 ≡ 0 (mod2) 与计算机中的 XOR 相同,所以矩阵法实际上可以通过 XOR 运算实现。
⚠️ 证明:矩阵哈希是 Universal Hashing,即 $P_H(h_H(x)=h_H(y)) ≤ {1\over m} = {1 \over 2^b}$
将碰撞转化为矩阵运算:hH(x) = H’x mod 2,故 hH(x)=hH(y) ↔ H’(x-y) = 0 (mod 2),令 z = x-y (mod2) = x ⊕ y;因为 x ≠ y,z ≠ 0。
考虑矩阵的任意一行,设矩阵第 i 行为 ri,则 $r_i z=\sum_{j=1}^{u}r_{ij}z_j\ (mod 2)$,由于 z 非 0,至少一个 zj = 1,r 取 0 或 1,故恰有一半可能使该行结果为 0—— Pr[ri z=0] = 1/2。
各行随机独立性,共 b 行各自随机取值,$P_H(h_H(x)=h_H(y)) = P_H(H’z = 0) = {1 \over 2^b}$
直觉: 因为两个不同 key 至少有一个 bit 不同,所以矩阵的每一行都有 1/2 的概率让它们碰撞;b 行独立,最终碰撞概率就是 1/2b。
⚠️ 我们对矩阵的要求是随机独立 Statistical Independent,而非线性独立 Linear Independent
Modular Arithmetic Method
假设一个 key 是 32-bit 整数,把它拆成四个 8-bit 整数 x = (x1, x2, x3, x4),其中 0 ≤ xi ≤ 255。
然后选择一个素数 p > 255 比如 257。因此 2 个不同的 8-bit 数字之差不可能是 257 的非零倍数。而且 257 是素数,这意味着所有非零模 257 元素都有乘法逆元。
接下来随机选择 a =(a1, a2, a3, a4),其中 ai ∈ {0, 1, …, 256}
⚠️ 定义 ha(x) = Σaixi mod p,输出范围为 0~p-1 所以哈希表大小 m = p
证明:碰撞概率为 1/p,即对任意 x ≠ y,Pa(ha(x) = ha(y)) = 1/p
将碰撞转化为模运算,碰撞时 ha(x) = ha(y) ↔ Σai(xi - yi) ≡ 0 (mod p)
考虑累加的任意一项,因为 x - y ≠ 0,所以至少存在一个 xj - yj ≠ 0 且 ∈ [-255, 255],可知 xj - yj ≠ 0 (mod p)
解得 aj ≡ -(Σexcept j ai(xi - yi)) (xj - yj)-1 (mod p) ——由于 p 质,逆元一定存在
⚠️ 这代表着一旦固定 a2, a3, a4 …,要发生冲突,a1 必须等于上述的唯一某特定值 —— 1/p 的概率选中哪该值
两种方法的共同证明技巧是:固定其他随机变量 → 碰撞要求某个随机变量取唯一值。这也是 Universal Hashing 证明中非常常见的思路
Rolling Hash 与 Rabin–Karp 算法
哈希除了哈希表还有一个应用:String Matching (字符串匹配)
对于较长文本 T,希望找到某个 Pattern P 在文本中出现的所有位置:在 T[n] 中找到所有符合 T[s+1, … s+m] = P[1, … m] 的 s。
朴素算法:从 Text 的每个可能起点开始,逐个比较 Pattern:遍历 T 中 n-m+1 个可作为起点的字符对比 P[1],对于符合者依次对比 P[2, … m],所以每个点最多对比 m 次——O(m(n-m+1)) = O(nm)
Rabin-Karp Alg.
既然逐个比较字符很慢,先快速计算某个哈希函数判断两个字符串是否可能相等
但是这里有一个问题:如果每次 m 个元素的窗口右移,都重新计算整个窗口的 Hash,还是需要 O(m) 吗——因此需要 Rolling Hash。
滚动哈希:将长度为 m 的字符串看成一个 B 进制整数 x = Σi=1m (diBm-i) 其中 di 代表从高到低第 i 位的数值。然后定义 h(x) = x mod q,其中 q 是一个大质数。
窗口右移时,先删除最高位 -d1Bm-1,然后乘 B 提高一位,然后加入新最低位 x’ = B(x - d1Bm-1) + dm+1。所以 h(x’) = (B(x - d1Bm-1) + dm+1) mod q。因此滚动哈希的更新计算 O(1)
其中所有运算都可以在模 q 下进行。实际实现时,通常预先计算 Bm-1 mod q 而不必先算出 x’
证明:Rabin-Karp 的复杂度
- 计算初始窗口的哈希 O(m)
- 共 n-m 次右移,每次更新哈希 O(1),所以 O(n-m)
- 如果两个不同的字符串哈希碰撞,需额外逐项比较验证 O(m),因为有 n-m+1 个窗口,且碰撞概率 1/q,所以期望时间成本为 O(nm/q)
- 假设实际有 v 次匹配,额外需要 O(mv) 证明
所以 E[T] = O(mv + n + nm/q) = O(n + mv),如果 v =O(1) 常数,则 O(n)
固定使用模 q 不能对任意两个不同的字符串保证碰撞概率为 1/q。实际分析需要对输入分布或哈希函数的随机选择作出额外假设
Rabin–Karp 最坏情况下仍然可能是 O(nm),因为大量窗口可能具有相同 Hash Value,或的确存在大量匹配
Table Doubling and Rehashing
Amortized Analysis (均摊分析) 与一直以来的 Average-case Analysis (平均情况分析) 不同,用于计算随时间不固定的时间成本
已证 E[Search T] = O(1+α),我们希望 α = O(1),即 n = O(m),但不断插入新元素 (增大 n),负载因子 α 会变大。使用 Table Doubling (表容量翻倍) 扩容:当 n = m 时将容量翻倍为 m’ = 2m。
⚠️ 由于哈希函数结果通常依赖哈希表容量 (例如模运算),元素在翻倍扩容后位置会变化,需要重计算哈希,不能仅仅扩容数组。
联想:Insert 不是每次都 O(1),若触发重哈希,最差需要 wcc Θ(n)。但扩容只会在阈值发生,虽然重哈希很昂贵但绝大多数 Insert 都 O(1) ——于是我们需要研究均摊成本。
这非常像之前说的建堆函数 BMH,直接讨论 wcc/average 不能得到时间复杂度的紧密上界
Aggregate Analysis 总成本分析
连续执行 n 次,基线成本 c0,扩容时成本 c,简化假设 n=2i,扩容时容量为 1, 2, 4, 8, …,2i+1 ——
那么总成本为 nc0 + c(2i+2 - 1) = nc0 + 4nc - c,所以 O(n),平均到 n 次插入就是 O(1),这就是均摊成本。
Accounting Method 记账法
假设每次插入都要支付一定的费用。
即使某次插入没有发生扩容,我们也让它付出 c0 + 4c ——
⚠️ 扩容到容量 s 需要 s·c 的成本,而上次扩容到 s/2 到下次扩容间有约 s/4 次普通插入,如果每次都存 4c 那么正好可以支付每次扩容。
因此虽然扩容操作越来越贵,但两次扩容之间的插入次数也在增加。每次插入只需要预留一个常数时间成本,就能支付未来的扩容。所以均摊成本还是 O(1)。
III. Cryptography
Cryptographic Hash Functions
对于 Hash Table,我们最关心的是:快速计算 Hash Value、让 Collision 概率尽量小、实现高效的 Search / Insert / Delete。但是 CHF 的目标不同:要求将任意长度数据映射到定长 Bit Array,并具备一定安全性质 (通常用于生成 MD (摘要))。
- 作为 One-way Function (单向函数),正向计算可能容易,但从输出反推输入必须难—— Pre-image Resistance (原像抗性)
- Second Pre-image Resistance (第二原像抗性):已知一个具体的输入,找另一个同哈希解的输入必须难
- Collision Resistance (抗碰撞性):同哈希解的不同值本身很难找到
对于理想的 (b)-bit Hash Function,常见的攻击工作量大约为:
Pre-image O(2b)、Second Pre-image O(2b)、Collision O(2b/2)
公钥加密
Number Theory*
公钥加密的前提是三个数论基础:
-
Factoring Problem 整数分解问题:给定较大合数将其分解成素数的乘积很难,但计算素数乘法简单
-
Primality Testing 素性测试:分解大整数很难,但判断一个大整数是否素数通过 Fermat’s Test 不难
根据费马小定律 FLT:对于小于 p 的正整数 a,ap-1 ≡ 1 (mod p)
费马测试:对给定 n-bit 整数 N 随机选小于它的正整数,若不通过 FLT 则一定不是素数;反之无法确定一定是素数 (大部分合数都 >50% 不通过测试)
-
随机生成 n-bit 质数:简单。任意 n-bit 数有约 1/n 概率为素,重复随机生成整数并做素性测试即可,平均尝试 O(n) 次找到一个素数。
⚠️ 生成大素数并相乘相对容易;将两个大素数的乘积分解回原来的素数却很难
RSA: Public Key Encryption 公钥加密
传统的 Symmetric Encryption 对称加密要求双方事先拥有相同密钥;但安全地交换密钥很难,公钥加密解决了这个问题。
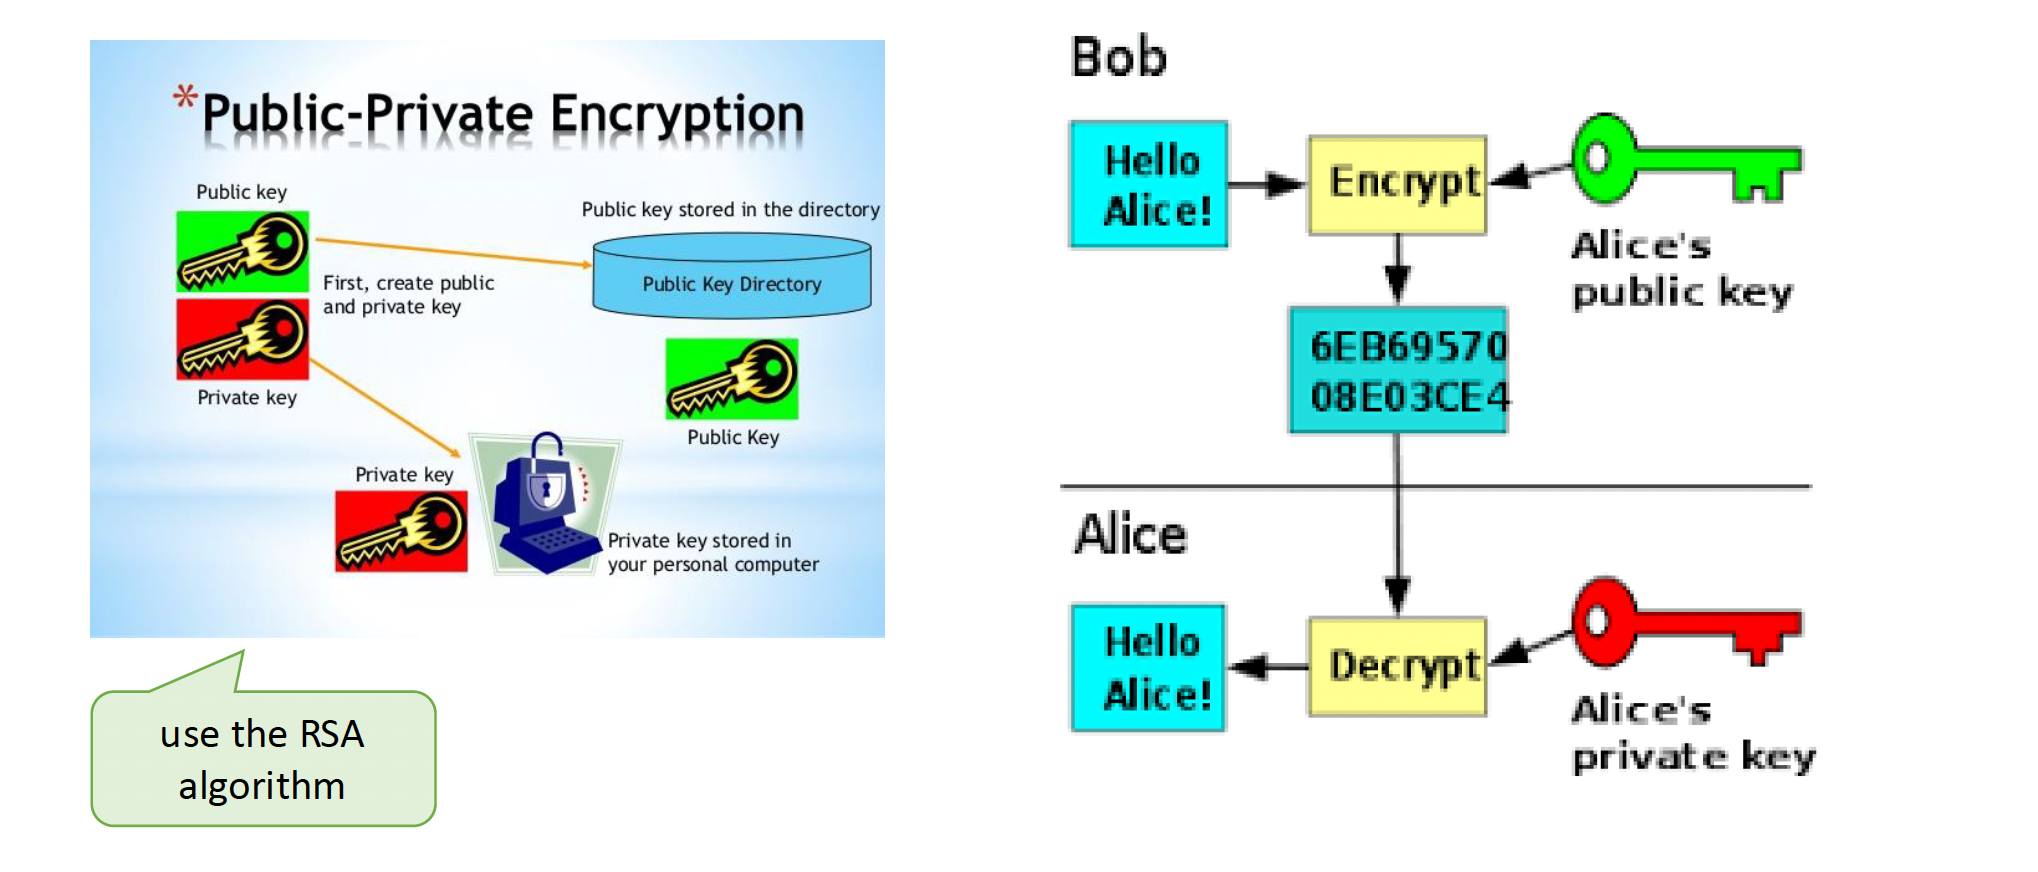
公钥用于加密,私钥用于解密,fpublic key = f-1private key。非对称加密是单向的,知道 Public Key 只能做加密,很难算出 Private Key
RSA 算法:
生成密钥:随机选取两个大质数 p、q,N = pq,欧拉函数 (Euler’s Totient Function):φ(N) = (p - 1)(q - 1) 表示 N 以下与其互素数的数量。选择一个整数 e,要求 gcd(e, φ(N)) = 1,需要找到 e 的乘法逆元 d,即 ed ≡ 1 (mod φ(N))。
加密:Public Key (N, e),加密算法 y = xe mod N
解密:Private Key d,解密算法 x = yd mod N
数字签名
RSA 保证只有持有私钥者可以轻松解密,但持有公钥者都可以做加密,需要“签名”说明信息来源和是否被修改。
- 发送者先计算信息 L 的摘要 MD = h(L),h 为 CHF,比如使用 SHA-256 会把 1G 数据哈希为 256b,对这个摘要 MD 用私钥签名更高效;
- 接收者收到 (Sig, L),先重新计算 MD‘ = h(L),通过公钥确认签名与 MD’ 匹配,并比对 MD = MD’ 。
SSL
访问 HTTPS 域时浏览器与服务器需要建立安全连接
- 验证服务器身份:浏览器连接服务器,服务器返回 Server Certificate (服务器证书由 CA 签发)、公钥、证书相关的身份信息——RSA 不验证身份,需要额外证书与可信身份验证。
- 建立 Shared Secret 共享秘密:浏览器随机生成一个 Session Key (会话密钥) K 后使用服务器公钥加密,服务器收到后用私钥解密,于是双方都知道 K,便建立安全的对称加密,可以双向通信。
- 使用对称加密传输数据:因为RSA 通常比 Symmetric Encryption 计算成本更高,用非对称加密传输对称密钥以便对称加密这种混合加密法是最合理的。